[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#lab08-opening-001)
# LAB 08 · 生成器与判别器的真实反馈
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#lab08-opening-002)
先阅读保存结果和解释,再按本册步骤选择是否运行。[在 Deepnote 阅读与运行](https://deepnote.com/project/6f83a923-d155-47be-be58-680db701ff7f/notebook/f16324b960a446e2aa03168c17e9fc0b) · [下载 Notebook](https://codingai-lec04.pages.dev/notebooks/lab08.ipynb)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-7f45dc2cdc9a4104ac8ab395e3332a98-001)
# LAB08|生成器与判别器怎样在反馈中改变
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-4e42058b87f148acaacac625c9f2bff5-001)
## 先看实验回答了什么
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-4e42058b87f148acaacac625c9f2bff5-002)
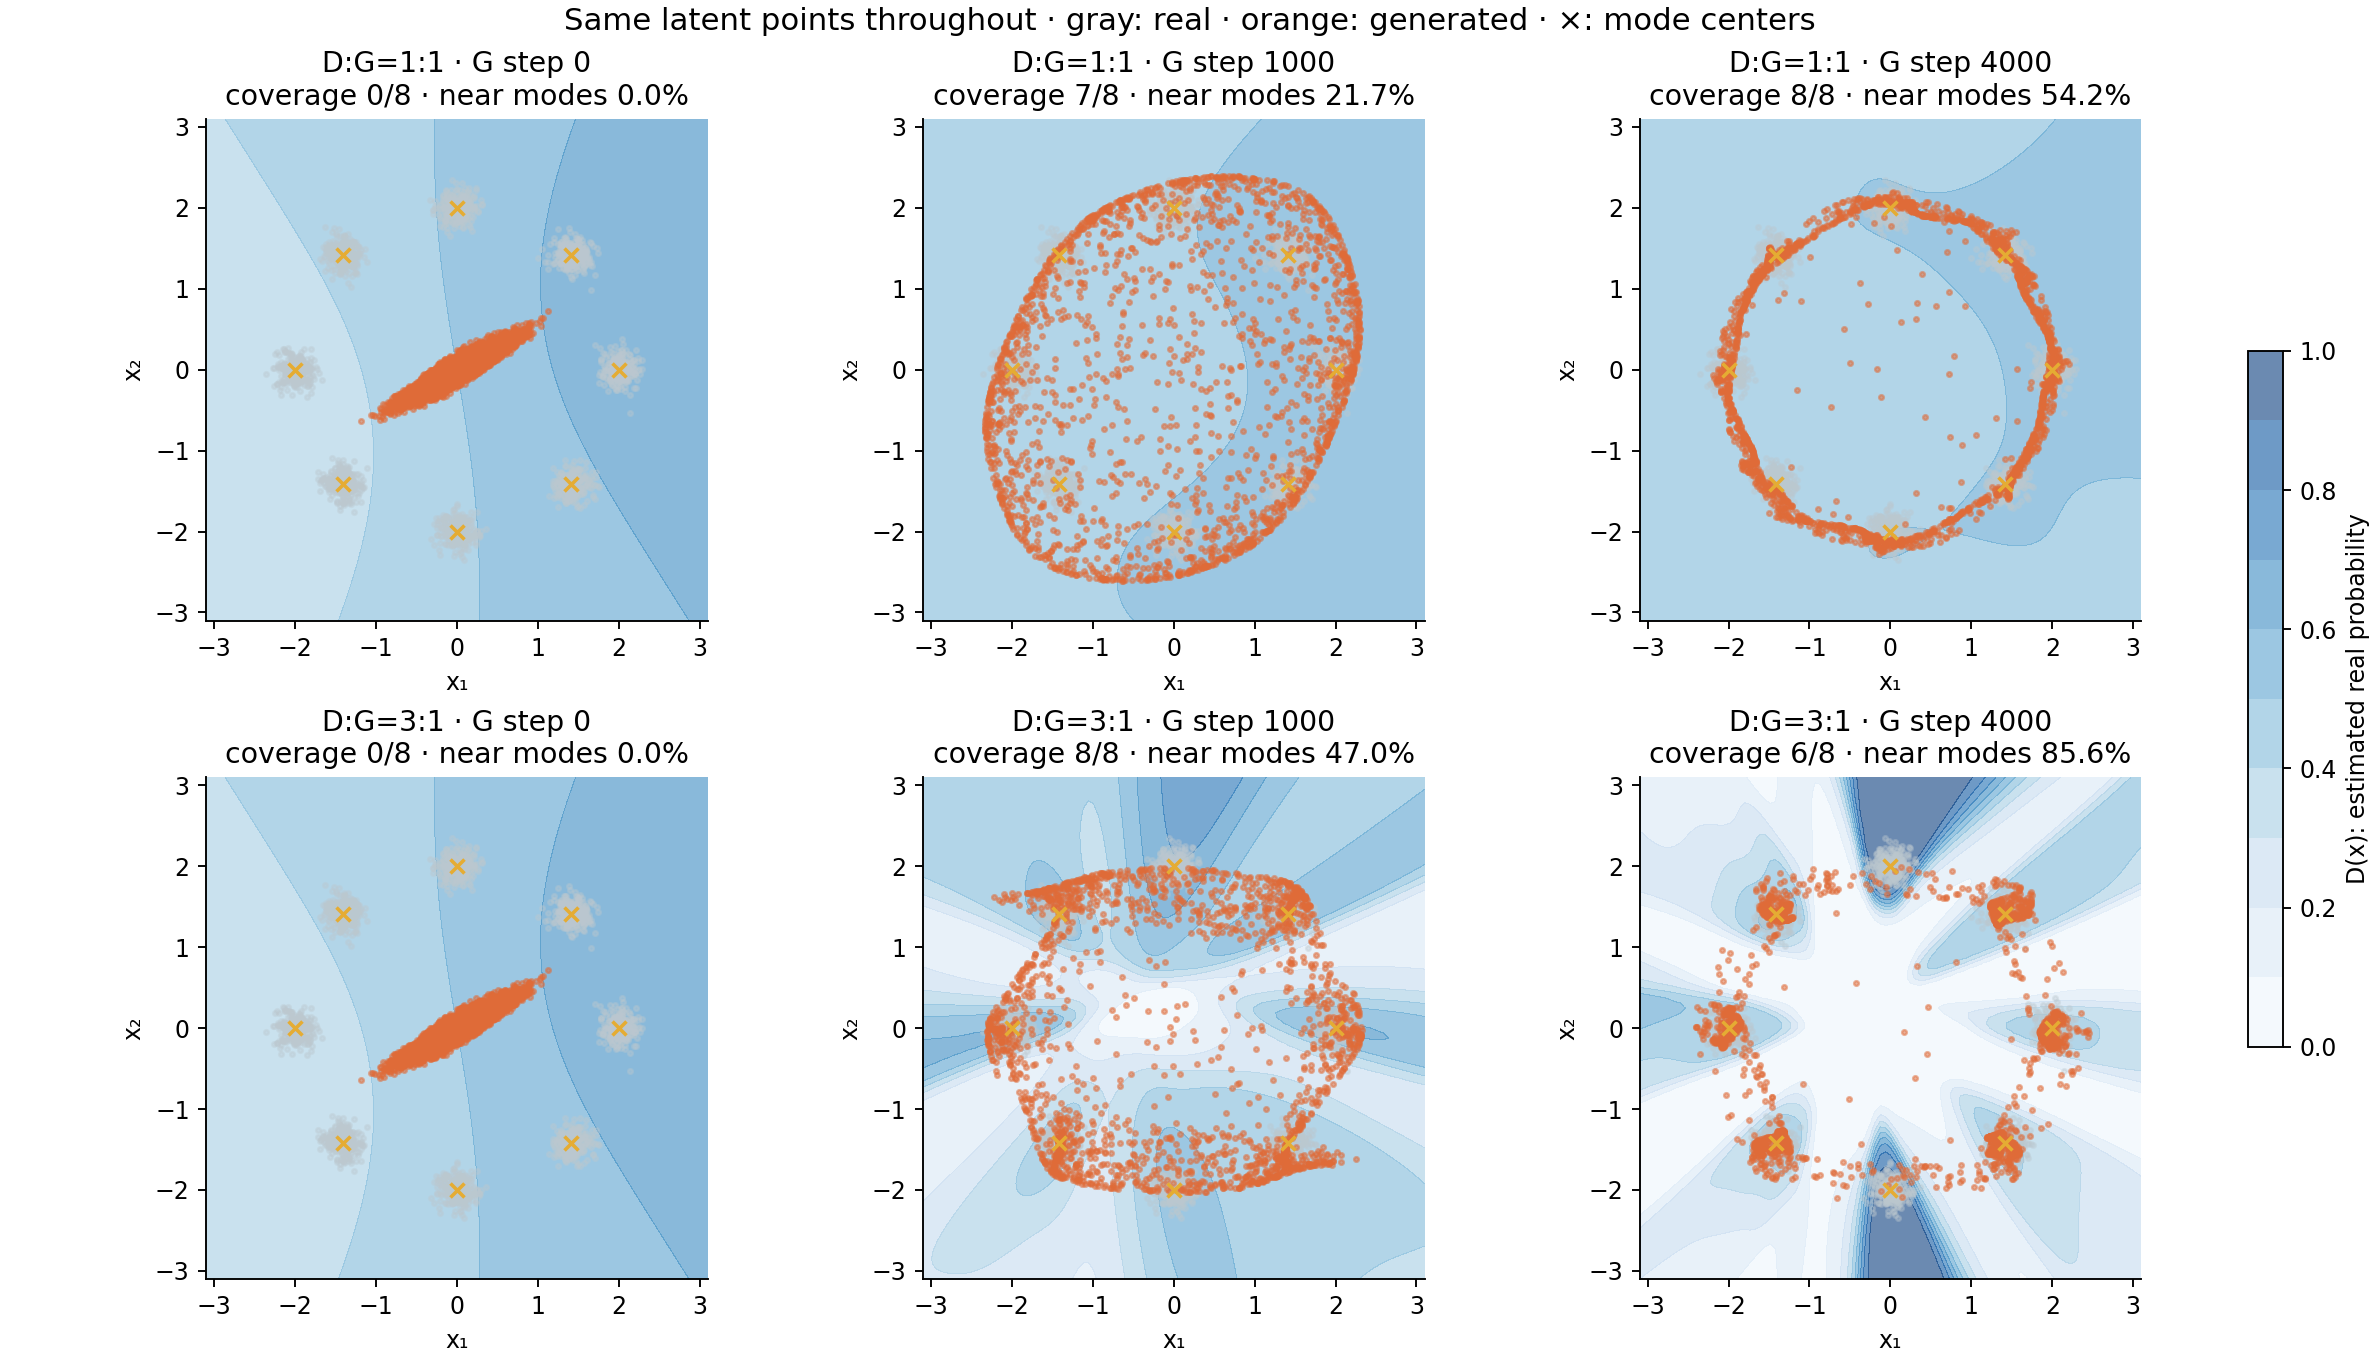
同一组随机起点,经过训练可以被映射到八个数据簇附近;但让判别器每轮多学几次,并不保证生成器覆盖得更完整。本次固定预算里,D:G=3:1 的点更集中,两个模式却明显不足。这个结果正好要求我们分开看**单个样本像不像**和**一批样本有没有覆盖不同可能性**。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-4e42058b87f148acaacac625c9f2bff5-003)
本册是真实训练的二维小 MLP GAN。它不是预写坐标动画,也不是 pix2pix、CycleGAN 或真实图像 GAN 的复现。全部图和数值来自同一次规定预算的 NumPy 运行;无需下载权重或数据。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-4e42058b87f148acaacac625c9f2bff5-004)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-4e42058b87f148acaacac625c9f2bff5-005)
先横着读上排:初始化的橙点聚在中央,后来沿环移动,最后到达八个簇附近,但簇间仍有许多点。再读下排:末态六个簇更紧密,上、下两个模式几乎没有样本。最后才看蓝色背景:这是当前 D 的判断,并非真实数据密度,也不是一个固定不动的教师答案。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-5566371e0b1640c9bbcb726554122153-001)
## 与 LAB09 共用的世界:八个可能区域
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-5566371e0b1640c9bbcb726554122153-002)
真实数据先均匀选一个编号 k∈{0,…,7},再从中心 μₖ 周围取二维高斯噪声。中心位于半径 2 的圆上,单坐标标准差为 0.12:
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-5566371e0b1640c9bbcb726554122153-003)
\[
\mu_k=2(\cos(2\pi k/8),\sin(2\pi k/8)),\quad
x=\mu_k+0.12\,\epsilon,\quad \epsilon\sim\mathcal N(0,I).
\]
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-5566371e0b1640c9bbcb726554122153-004)
G 的输入是二维标准正态 z;输出是二维坐标。G 没有得到“这个 z 应去第几个模式”的配对标签。D 得到真实坐标和 G 产生的坐标,并学习分辨二者。两方都有两个 64 单元的 tanh 隐藏层;同一套参数处理所有样本。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-5566371e0b1640c9bbcb726554122153-005)
覆盖读法提前固定:以每个中心为圆心,半径 0.36(单坐标标准差的三倍)作为邻域;2048 个生成点中,至少 1% 落入该邻域才计为覆盖一个模式。近模式比例是落入八个邻域的点占全部生成点的比例。这是二维圆邻域,不应套用一维“三倍标准差覆盖99.7%”的说法。两项都要看:全部点坍塌到一个中心时近模式比例可以接近100%,覆盖却只有1/8。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-02f96aaaa1f24c178aec518b2b676bec-001)
## 一次 D 更新:谁得到纠正
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-02f96aaaa1f24c178aec518b2b676bec-002)
令 l 为 D 输出的 logit,D(x)=sigmoid(l)。D 在一个 256 真样本+256 生成样本的拼接批次上最小化二元交叉熵的平均值。真实标签为1,生成标签为0。对每个 logit 的梯度是 (D(x)−y)/批次总数。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-02f96aaaa1f24c178aec518b2b676bec-003)
```
fake, _ = G.forward(z) # 只保留数值,丢弃 G 的中间缓存
logits, cacheD = D.forward(concatenate([real, fake]))
_, gradsD = D.backward(cacheD, (sigmoid(logits) - labels) / len(labels))
D.update(gradsD, lr)
# 没有 G.backward,也没有 G.update
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-02f96aaaa1f24c178aec518b2b676bec-004)
NumPy 不会隐式构建自动求导图,所以“切断”是可检查的:D 步只有 fake 的数值流入 D,代码根本没有计算或施加 G 的参数梯度。PyTorch 中对生成结果使用 detach,承担的是相同的边界职责。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-02f96aaaa1f24c178aec518b2b676bec-005)
独立的32+32样本实际梯度探针里,第一真实点为 (0.0734, −2.3492),D给出0.48681;它对logit的梯度为−0.008019,梯度下降会把真实分数推高。第一生成点为 (−0.2576, 0.04149),D给出0.47562;梯度为+0.007432,会把生成分数推低。本次D步使D参数的变化范数为0.01994,G参数变化**严格为0**。这些是运行记录,不是为公式手编的数值。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-3e06c15a86ac45cbada06240f2f34994-001)
## 一次 G 更新:固定 D 不等于绕过 D
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-3e06c15a86ac45cbada06240f2f34994-002)
G 使用非饱和目标 −mean(log D(G(z)))。它希望生成结果被判为真,所以此时用于计算 G 损失的目标是1。目标改变不代表我们谎称生成点是真实数据:这是两方不同的优化目标。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-3e06c15a86ac45cbada06240f2f34994-003)
```
fake, cacheG = G.forward(z)
logits, cacheD = D.forward(fake)
d_fake, unused_D_grads = D.backward(cacheD, (sigmoid(logits)-1)/len(z))
_, gradsG = G.backward(cacheG, d_fake)
G.update(gradsG, lr)
# D 的导数参与链式法则,但没有 D.update
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-3e06c15a86ac45cbada06240f2f34994-004)
此刻 D 像一张暂时固定的地形:它告诉 G 输出坐标往哪个方向挪会改变评分。反向计算必须经过 D 对输入的导数,才能继续到 G 的参数;如果连这条导数也切断,G 就得不到当前评分如何依赖自己输出的信息。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-3e06c15a86ac45cbada06240f2f34994-005)
在紧接前一D步的实际探针中,第一生成点的 D 概率为0.47713,G损失对logit的梯度为−0.01634;传到二维生成坐标上的梯度为 (−0.005727, −0.001027)。再沿G反传后,G参数改变0.02008,D参数变化**严格为0**。这里的参数变化是一次Adam更新后的范数,不应误读成坐标立即移动了同样距离。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-3e06c15a86ac45cbada06240f2f34994-006)
**学生常问:既然 D 固定了,梯度怎么还能经过它?** 固定的是参数取值和是否更新;函数在当前输入处仍有导数。就像固定函数 f(x)=2x 不会让 df/dx 消失。这段解释补上了“交替优化”一词往往掩盖的机制。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-a458dff9c56444d59ef60330f2babde4-001)
## 一个设置的对照:更多反馈改变了什么
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-a458dff9c56444d59ef60330f2babde4-002)
两臂从相同 G、D 初始化出发;每个 G 迭代使用相同真实批次、同一组 zD 与 zG。3:1 对同一 D 批次重复三次优化,1:1只做一次。两臂各做4000次G更新,因此**G预算相同,D计算量不同**;这不是等总算力对照。学习率均为0.0003,Adam β₁=0.5、β₂=0.99。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-a458dff9c56444d59ef60330f2babde4-003)
| 设置/时点 | 覆盖模式 | 近模式比例 | 最近中心距离中位数 |
| --- | --- | --- | --- |
| 相同初始化 | 0/8 | 0.00% | 1.6639 |
| 1:1,1000次G更新 | 7/8 | 21.68% | 0.6077 |
| 1:1,4000次G更新 | 8/8 | 54.25% | 0.3248 |
| 3:1,1000次G更新 | 8/8 | 47.02% | 0.3760 |
| 3:1,4000次G更新 | 6/8 | 85.64% | 0.1623 |
| 独立真实样本参照 | 8/8 | 99.17% | 0.1392 |
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-a458dff9c56444d59ef60330f2babde4-004)
3:1末态的八个邻域计数依次为279、290、10、282、259、285、16、333。第2和第6号模式未达到每模至少21个点的覆盖阈值;它们并非数学上完全不可能被生成,而是在本次样本与规定读法中明显欠覆盖。1:1覆盖更完整,却仍有约46%的点不在近模式邻域。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-a458dff9c56444d59ef60330f2babde4-005)
这个固定种子的对照支持“本次更多D更新带来更密集但不完整的结果”,不支持“多训D必然导致坍塌”。我们没有挑选失败图,也没有尝试别的参数直到出现想要的故事。距离更近也不自动证明分布更准确:把每个模式都压成一个点,会丢掉模式内部的真实方差。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-a458dff9c56444d59ef60330f2babde4-006)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-a458dff9c56444d59ef60330f2babde4-007)
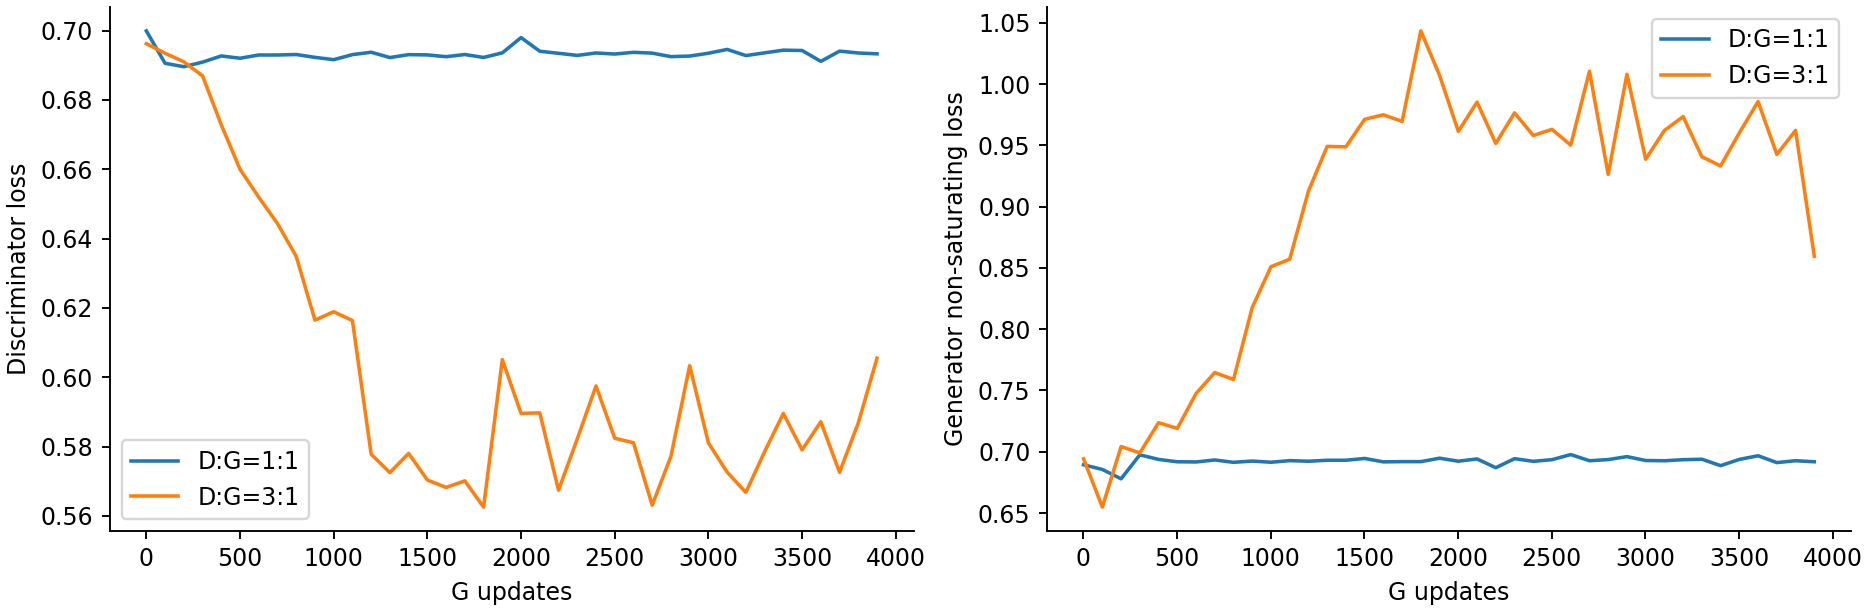
D损失和G损失回答“当前对手下这一步有多难”,而覆盖回答“最终样本去了哪里”。两方同时变化,损失不必单调下降;比较图像、覆盖和分布应在明确冻结的采样条件下进行。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-7f18e8aa91734df9af94a831ce23cc63-001)
## 自己运行与只改一个变量
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-7f18e8aa91734df9af94a831ce23cc63-002)
本册的实现已在独立 Python 进程实际运行;两臂合计约24.05秒,环境为 Python 3.12.14、NumPy 2.3.5、单线程BLAS。不同机器时间会变化。依赖为 NumPy、Matplotlib 与 threadpoolctl;运行后在 outputs 目录保存图、完整样本、判别场、权重和结果JSON。Notebook与 .py 包含相同完整实现,不依赖其他册的变量。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-7f18e8aa91734df9af94a831ce23cc63-003)
默认直接运行全部单元即可重建基线。建议第一次只观察已有的1:1/3:1对照,不需要继续搜索设置。若要再做一次学习任务,可固定全部设置,仅把 G 的训练步数改为2000,并同步改最后的checkpoint。先写下预期,再读取近模式比例、每模式计数与真实图,解释是否出现了“更密集却遗漏模式”。不要只保留更好看的那一张。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-7f18e8aa91734df9af94a831ce23cc63-004)
**自检。** 如果G步误用了fake.detach,会怎样?答案:D仍能算分数,但关于G参数的梯度路径被切断,生成器无法从此损失学习。若D步也更新G,两方优化边界就变了,不再是本册规定的交替训练算法。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-7f18e8aa91734df9af94a831ce23cc63-005)
重算时,`run()` 用 threadpoolctl 将这一次实验的 BLAS 计算限为单线程,并在结果 JSON 保存实际线程信息。Notebook 内核可能已加载 NumPy,只在代码中设置环境变量不能可靠改变已启动的线程池。这个执行控制不改变数据、随机种子、训练预算或采样规则;运行时间仍按当前机器实测,不能将本地秒数当作云端承诺。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-7f18e8aa91734df9af94a831ce23cc63-006)
**云端复核(2026-09-30)。** 本册在 Deepnote 的独立内核按自身步骤完整运行。两臂各完成4000次 G 更新;D:G=1:1 的近模式比例为54.25%、覆盖8/8,3:1为85.64%、覆盖6/8。D步只改变D,G步梯度经过D但只改变G的参数,实际参数差验证了这两条路径。上方原始保存图继续标为本地基线,两次测量分别记录;大图在插件的运行快照预览中可能因尺寸被省略,这不代替学生在同册查看自己的输出。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-76208f8f422848ed82d4e290bd26c2cb-001)
## 从二维反馈回到图像方法
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-76208f8f422848ed82d4e290bd26c2cb-002)
这里看见的是学习反馈怎样塑造分布。图像翻译还要说明输入条件怎样进入G和D、配对监督从哪里来、循环或潜变量重建约束解决什么问题。小GAN不会替这些设计作证明。继续读第四章与CLS04,再回到LAB03的循环一致反例,可以区分“会学习逼真反馈”和“能保证语义对应”两个问题。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-76208f8f422848ed82d4e290bd26c2cb-003)
来源:Goodfellow 等,[Generative Adversarial Nets](https://arxiv.org/abs/1406.2661),重点看交替更新算法与非饱和生成器目标。本文的二维数据、预算和对照是课程实现,不是原论文结果。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-59584570310a49b08371d9bf917fc307-001)
## 完整可运行实现
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-59584570310a49b08371d9bf917fc307-002)
下面代码与下载版 `.py` 同源。先读上面的已保存实测结果;从新内核按顺序运行以下代码,可重新训练并保存自己的图、权重、数组与指标。这里显示的既有图来自独立 Python 进程,不冒称已在当前 Deepnote 计算实例中运行。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-f9b21400f34b426eba709efb5fd12600-001)
查看可执行代码
```
# Dependencies: Python 3.10+, numpy, matplotlib, threadpoolctl. No downloads or hidden notebook state.
import os
os.environ.setdefault('OPENBLAS_NUM_THREADS','1')
os.environ.setdefault('OMP_NUM_THREADS','1')
import json, time, math, hashlib, platform
from pathlib import Path
import numpy as np
from threadpoolctl import threadpool_limits, threadpool_info
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
CENTERS = 2.0*np.stack([np.cos(np.arange(8)*2*np.pi/8),np.sin(np.arange(8)*2*np.pi/8)],axis=1)
DATA_STD = .12
def draw_data(rng,n):
k=rng.integers(0,8,n)
return CENTERS[k]+DATA_STD*rng.normal(size=(n,2))
def coverage(x):
dist=np.linalg.norm(x[:,None,:]-CENTERS[None,:,:],axis=2)
nearest=dist.argmin(1); inside=dist.min(1)<=3*DATA_STD
counts=np.bincount(nearest[inside],minlength=8)
return {'n':len(x),'covered_modes':int(np.sum(counts>=.01*len(x))),
'mode_counts_within_3sigma':counts.tolist(),'on_mode_fraction':float(inside.mean()),
'median_distance_to_center':float(np.median(dist.min(1))),
'off_plot_fraction':float(np.mean(np.any(abs(x)>3.1,axis=1)))}
class MLP:
def __init__(self,sizes,seed,final_scale=1.):
rng=np.random.default_rng(seed); self.p=[]
for k,(a,b) in enumerate(zip(sizes[:-1],sizes[1:])):
scale=final_scale if k==len(sizes)-2 else 1.
self.p.extend([rng.normal(size=(a,b))*np.sqrt(2/(a+b))*scale,np.zeros(b)])
self.m=[np.zeros_like(p) for p in self.p]; self.v=[np.zeros_like(p) for p in self.p]; self.step=0
def forward(self,x):
acts=[x]
for k in range(0,len(self.p),2):
x=x@self.p[k]+self.p[k+1]
if k
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-e8faf3e5f9e8429d8f1620a41fc7fc32-001)
查看可执行代码
```
# Frozen settings: the comparison changes only D updates per G update.
CONFIG={'seed_model':700,'seed_training':701,'seed_evaluation':702,'steps':4000,'batch':256,
'learning_rate_G':.0003,'learning_rate_D':.0003,'D_updates':[1,3],
'architecture_G':[2,64,64,2],'architecture_D':[2,64,64,1],
'checkpoints':[0,1000,4000],'data':'8 equal Gaussian modes; radius=2; sigma=.12',
'coverage':'At least 1% of all 2048 generated points within radius .36 of a center',
'seed_policy':'same initialization, same real/zD/zG batch at each G iteration; extra D updates reuse that batch',
'budget_note':'Equal G updates, unequal D computation. No hyperparameter search.'}
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-394bcae81be8438fac5aadb5aa94a675-001)
查看可执行代码
```
# A real D step and a real G step. NumPy has no implicit graph.
def d_step(G,D,real,z,lr):
fake,_=G.forward(z) # values only: G cache is discarded; no G backward or optimizer call
inp=np.concatenate([real,fake]); target=np.concatenate([np.ones((len(real),1)),np.zeros((len(fake),1))])
logits,cacheD=D.forward(inp)
_,gradsD=D.backward(cacheD,(sigmoid(logits)-target)/len(inp))
loss=float(bce_logits(logits,target)); D.update(gradsD,lr,b1=.5,b2=.99)
return loss
def g_step(G,D,z,lr):
fake,cacheG=G.forward(z); logits,cacheD=D.forward(fake)
# Non-saturating G loss is -mean(log D(G(z))). D backward supplies dL/dfake.
d_fake,unused_D_grads=D.backward(cacheD,(sigmoid(logits)-1)/len(z))
_,gradsG=G.backward(cacheG,d_fake)
loss=float(bce_logits(logits,1)); G.update(gradsG,lr,b1=.5,b2=.99)
# D.update is deliberately absent: its Jacobian is used, its weights are fixed.
return loss,{'dL_dfake_norm':float(np.linalg.norm(d_fake)),
'dL_dGparams_norm':float(np.linalg.norm(np.concatenate([g.ravel() for g in gradsG])))}
def gradient_probe(G,D,rng):
real=draw_data(rng,32); z=rng.normal(size=(32,2))
beforeG=G.flat().copy(); beforeD=D.flat().copy()
fake=G.forward(z)[0]; logit_real=D.forward(real)[0]; logit_fake=D.forward(fake)[0]
lossD=d_step(G,D,real,z,CONFIG['learning_rate_D'])
record={'D_step':{'loss':lossD,'G_parameter_change':float(np.linalg.norm(G.flat()-beforeG)),
'D_parameter_change':float(np.linalg.norm(D.flat()-beforeD)),
'first_real':real[0].tolist(),'first_generated':fake[0].tolist(),
'first_real_logit':float(logit_real[0,0]),'first_real_probability':float(sigmoid(logit_real)[0,0]),
'first_fake_logit':float(logit_fake[0,0]),'first_fake_probability':float(sigmoid(logit_fake)[0,0]),
'first_real_dL_dlogit':float((sigmoid(logit_real)[0,0]-1)/64),
'first_fake_dL_dlogit':float(sigmoid(logit_fake)[0,0]/64)}}
beforeG=G.flat().copy(); beforeD=D.flat().copy()
fake,cacheG=G.forward(z); lg,cd=D.forward(fake); dx,_=D.backward(cd,(sigmoid(lg)-1)/len(z))
lossG,details=g_step(G,D,z,CONFIG['learning_rate_G'])
record['G_step']={'loss':lossG,'G_parameter_change':float(np.linalg.norm(G.flat()-beforeG)),
'D_parameter_change':float(np.linalg.norm(D.flat()-beforeD)),
'first_fake_logit':float(lg[0,0]),'first_fake_probability':float(sigmoid(lg)[0,0]),
'first_dL_dlogit':float((sigmoid(lg)[0,0]-1)/len(z)),
'first_dL_dfake':dx[0].tolist(),**details}
return record
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-6ba30faa9eb640099a9b44ddf476ef5d-001)
查看可执行代码
```
# Train both frozen arms and save every stated result.
@threadpool_limits.wrap(limits=1, user_api='blas')
def run(output_dir='outputs'):
begin=time.time(); out=Path(output_dir); out.mkdir(parents=True,exist_ok=True); setup_style()
max_grad_error=check_gradient()
erng=np.random.default_rng(CONFIG['seed_evaluation']); fixed_z=erng.normal(size=(2048,2)); real=draw_data(erng,2048)
grid_axis=np.linspace(-3.1,3.1,101); xx,yy=np.meshgrid(grid_axis,grid_axis); grid=np.c_[xx.ravel(),yy.ravel()]
records={}; saved={'centers':CENTERS,'fixed_z':fixed_z,'real_evaluation':real,'grid':grid}
fig,axes=plt.subplots(2,3,figsize=(14,8),constrained_layout=True)
lossfig,lossaxes=plt.subplots(1,2,figsize=(11,3.6),constrained_layout=True)
for row,ratio in enumerate(CONFIG['D_updates']):
G=MLP(CONFIG['architecture_G'],CONFIG['seed_model']); D=MLP(CONFIG['architecture_D'],CONFIG['seed_model']+1)
rng=np.random.default_rng(CONFIG['seed_training']); snaps={}; curve=[]; start=time.time()
for step in range(CONFIG['steps']+1):
if step in CONFIG['checkpoints']:
generated=G.forward(fixed_z)[0]; field=sigmoid(D.forward(grid)[0]).reshape(xx.shape)
metrics=coverage(generated); snaps[str(step)]=metrics
saved[f'd{ratio}_step{step}_samples']=generated; saved[f'd{ratio}_step{step}_Dfield']=field
ax=axes[row,CONFIG['checkpoints'].index(step)]
mesh=ax.contourf(xx,yy,field,levels=np.linspace(0,1,11),cmap='Blues',alpha=.6)
scatter_base(ax,real); ax.scatter(generated[:,0],generated[:,1],s=4,c='#e06b38',alpha=.5,rasterized=True)
ax.set_title(f'D:G={ratio}:1 · G step {step}\ncoverage {metrics["covered_modes"]}/8 · near modes {metrics["on_mode_fraction"]:.1%}')
if step==CONFIG['steps']: break
real_batch=draw_data(rng,CONFIG['batch']); zD=rng.normal(size=(CONFIG['batch'],2)); zG=rng.normal(size=(CONFIG['batch'],2))
for _ in range(ratio): lossD=d_step(G,D,real_batch,zD,CONFIG['learning_rate_D'])
lossG,_=g_step(G,D,zG,CONFIG['learning_rate_G'])
if step%100==0: curve.append([step+1,lossD,lossG])
np.savez_compressed(out/f'lab08-d{ratio}-weights.npz',**{f'G_{k}':v for k,v in G.state().items()},**{f'D_{k}':v for k,v in D.state().items()})
curve=np.array(curve); saved[f'd{ratio}_losses']=curve
lossaxes[0].plot(curve[:,0],curve[:,1],label=f'D:G={ratio}:1');lossaxes[1].plot(curve[:,0],curve[:,2],label=f'D:G={ratio}:1')
records[f'D_updates_{ratio}']={'snapshots':snaps,'elapsed_seconds':time.time()-start}
fig.colorbar(mesh,ax=axes,label='D(x): estimated real probability',shrink=.6)
fig.suptitle('Same latent points throughout · gray: real · orange: generated · ×: mode centers',fontsize=13)
fig.savefig(out/'lab08-training.png',dpi=170);plt.close(fig)
for ax,title in zip(lossaxes,['Discriminator loss','Generator non-saturating loss']): ax.set(xlabel='G updates',ylabel=title);ax.legend()
lossfig.savefig(out/'lab08-losses.png',dpi=170);plt.close(lossfig)
probe=gradient_probe(MLP(CONFIG['architecture_G'],CONFIG['seed_model']),MLP(CONFIG['architecture_D'],CONFIG['seed_model']+1),np.random.default_rng(910))
np.savez_compressed(out/'lab08-data.npz',**saved)
report={'config':CONFIG,'results':records,'gradient_probe':probe,'gradient_check_max_abs_error':max_grad_error,
'runtime_seconds':time.time()-begin,'python':platform.python_version(),'numpy':np.__version__,
'blas_threadpools':threadpool_info(),
'run_utc':time.strftime('%Y-%m-%dT%H:%M:%SZ',time.gmtime()),'real_reference_coverage':coverage(real)}
dump_json(out/'lab08-metrics.json',report);print(json.dumps(report,ensure_ascii=False,indent=2));return report
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-96d0204df39f47b4b6e4ed6e931424c6-001)
查看可执行代码
```
report = run('outputs')
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-96d0204df39f47b4b6e4ed6e931424c6-output-0-001)
查看保存的计算输出
```
{
"config": {
"seed_model": 700,
"seed_training": 701,
"seed_evaluation": 702,
"steps": 4000,
"batch": 256,
"learning_rate_G": 0.0003,
"learning_rate_D": 0.0003,
"D_updates": [
1,
3
],
"architecture_G": [
2,
64,
64,
2
],
"architecture_D": [
2,
64,
64,
1
],
"checkpoints": [
0,
1000,
4000
],
"data": "8 equal Gaussian modes; radius=2; sigma=.12",
"coverage": "At least 1% of all 2048 generated points within radius .36 of a center",
"seed_policy": "same initialization, same real/zD/zG batch at each G iteration; extra D updates reuse that batch",
"budget_note": "Equal G updates, unequal D computation. No hyperparameter search."
},
"results": {
"D_updates_1": {
"snapshots": {
"0": {
"n": 2048,
"covered_modes": 0,
"mode_counts_within_3sigma": [
0,
0,
0,
0,
0,
0,
0,
0
],
"on_mode_fraction": 0.0,
"median_distance_to_center": 1.6638549925234734,
"off_plot_fraction": 0.0
},
"1000": {
"n": 2048,
"covered_modes": 7,
"mode_counts_within_3sigma": [
103,
35,
55,
55,
75,
32,
19,
70
],
"on_mode_fraction": 0.216796875,
"median_distance_to_center": 0.6076510860265074,
"off_plot_fraction": 0.0
},
"4000": {
"n": 2048,
"covered_modes": 8,
"mode_counts_within_3sigma": [
128,
143,
164,
148,
124,
101,
163,
140
],
"on_mode_fraction": 0.54248046875,
"median_distance_to_center": 0.32482193534371595,
"off_plot_fraction": 0.0
}
},
"elapsed_seconds": 15.850052118301392
},
"D_updates_3": {
"snapshots": {
"0": {
"n": 2048,
"covered_modes": 0,
"mode_counts_within_3sigma": [
0,
0,
0,
0,
0,
0,
0,
0
],
"on_mode_fraction": 0.0,
"median_distance_to_center": 1.6638549925234734,
"off_plot_fraction": 0.0
},
"1000": {
"n": 2048,
"covered_modes": 8,
"mode_counts_within_3sigma": [
127,
179,
40,
128,
128,
157,
54,
150
],
"on_mode_fraction": 0.47021484375,
"median_distance_to_center": 0.3759880884700424,
"off_plot_fraction": 0.0
},
"4000": {
"n": 2048,
"covered_modes": 6,
"mode_counts_within_3sigma": [
279,
290,
10,
282,
259,
285,
16,
333
],
"on_mode_fraction": 0.8564453125,
"median_distance_to_center": 0.1623375488908803,
"off_plot_fraction": 0.0
}
},
"elapsed_seconds": 30.7358877658844
}
},
"gradient_probe": {
"D_step": {
"loss": 0.7374548193319083,
"G_parameter_change": 0.0,
"D_parameter_change": 0.01993765754756485,
"first_real": [
0.07340117214257046,
-2.3491666345894755
],
"first_generated": [
-0.2576279886478896,
0.04148777982071576
],
"first_real_logit": -0.05276182833296705,
"first_real_probability": 0.48681260204293425,
"first_fake_logit": -0.09760943391934174,
"first_fake_probability": 0.47561699774099214,
"first_real_dL_dlogit": -0.008018553093079153,
"first_fake_dL_dlogit": 0.007431515589703002
},
"G_step": {
"loss": 0.6882525396619139,
"G_parameter_change": 0.02007749873901901,
"D_parameter_change": 0.0,
"first_fake_logit": -0.09155189697681232,
"first_fake_probability": 0.4771279991403109,
"first_dL_dlogit": -0.016339750026865284,
"first_dL_dfake": [
-0.005727314823879403,
-0.0010267512323057764
],
"dL_dfake_norm": 0.03087642494617375,
"dL_dGparams_norm": 0.3919912784600375
}
},
"gradient_check_max_abs_error": 1.4114598378967003e-11,
"runtime_seconds": 55.833566665649414,
"python": "3.13.12",
"numpy": "2.4.6",
"blas_threadpools": [
{
"user_api": "blas",
"internal_api": "openblas",
"num_threads": 1,
"prefix": "libscipy_openblas",
"filepath": "/root/venv/lib/python3.13/site-packages/numpy.libs/libscipy_openblas64_-32a4b2a6.so",
"version": "0.3.31.188.0",
"threading_layer": "pthreads",
"architecture": "Haswell"
}
],
"run_utc": "2026-09-30T02:24:33Z",
"real_reference_coverage": {
"n": 2048,
"covered_modes": 8,
"mode_counts_within_3sigma": [
239,
253,
275,
259,
251,
257,
240,
257
],
"on_mode_fraction": 0.99169921875,
"median_distance_to_center": 0.139217189657945,
"off_plot_fraction": 0.0
}
}
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/f16324b960a446e2aa03168c17e9fc0b.html#block-edecbc164b914345ba5544355bc0c9f8-001)
查看可执行代码
```
from IPython.display import display, Image
display(Image(filename='outputs/lab08-training.png'))
display(Image(filename='outputs/lab08-losses.png'))
```