[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#lab01-opening-001)
# LAB 01 · 自回归:联合概率、贪心与温度
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#lab01-opening-002)
先阅读保存结果和解释,再按本册步骤选择是否运行。[在 Deepnote 阅读与运行](https://deepnote.com/project/6f83a923-d155-47be-be58-680db701ff7f/notebook/39071d41f84d4621ad69c6140a6dccc9) · [下载 Notebook](https://codingai-lec04.pages.dev/notebooks/lab01.ipynb)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-b94a88a25a974c3e95bb22d89421a340-001)
# 自回归:每一步最可能,整句就最可能吗?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-b94a88a25a974c3e95bb22d89421a340-002)
本册用一个可以完全枚举的两步模型回答三个问题:联合概率怎样由条件概率组成;贪心为何可能错过最高概率序列;温度究竟改变了什么。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-b94a88a25a974c3e95bb22d89421a340-003)
**先预测,再运行。** 第一步 `P(A)=0.6, P(B)=0.4`;接着 `P(0|A)=0.51, P(1|A)=0.49`,`P(0|B)=0.99, P(1|B)=0.01`。你会选哪个完整序列?先写出逐步贪心的答案,再算四个联合概率。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-b94a88a25a974c3e95bb22d89421a340-004)
你的产出是一张四行概率表,以及一句区分“概率最高”“从分布采样”“提高温度”的解释。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-b94a88a25a974c3e95bb22d89421a340-005)
**本轮入口:先看下面的保存图,再只改一个参数。** 原有可手算代码与推导完整保留在后面。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-459cd54da2664cbc8da31cae0412730b-001)
## 先看问题与保存结果
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-459cd54da2664cbc8da31cae0412730b-002)
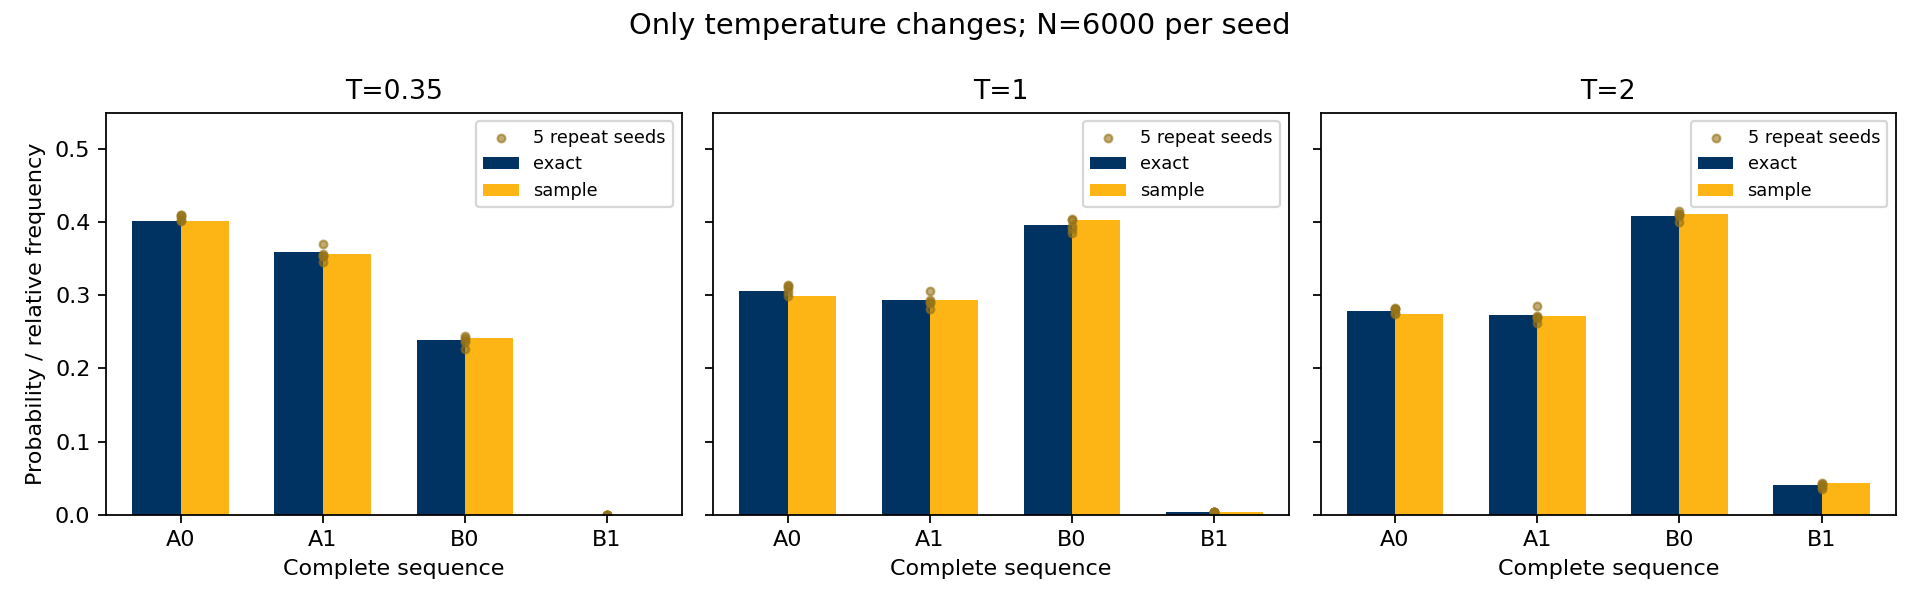
这是一张给定概率表的解析实验。先比较整条路径与局部最优,再改变温度;代码没有训练语言模型。保存图显示温度改变的是每个前缀后的条件分布,完整路径还要把沿途概率相乘。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-459cd54da2664cbc8da31cae0412730b-003)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-459cd54da2664cbc8da31cae0412730b-004)
[连续概念解释](https://codingai-lec04.pages.dev/lecture.html#ch02)。读完后留下一个结果:固定量、改变项、实际观察,以及它支持的机制。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-3f5f23b769b34b2db84a673efb6a82c0-001)
## 先看保存结果:同一概率表的树、完整序列与温度
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-3f5f23b769b34b2db84a673efb6a82c0-002)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-3f5f23b769b34b2db84a673efb6a82c0-003)

[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-3f5f23b769b34b2db84a673efb6a82c0-004)
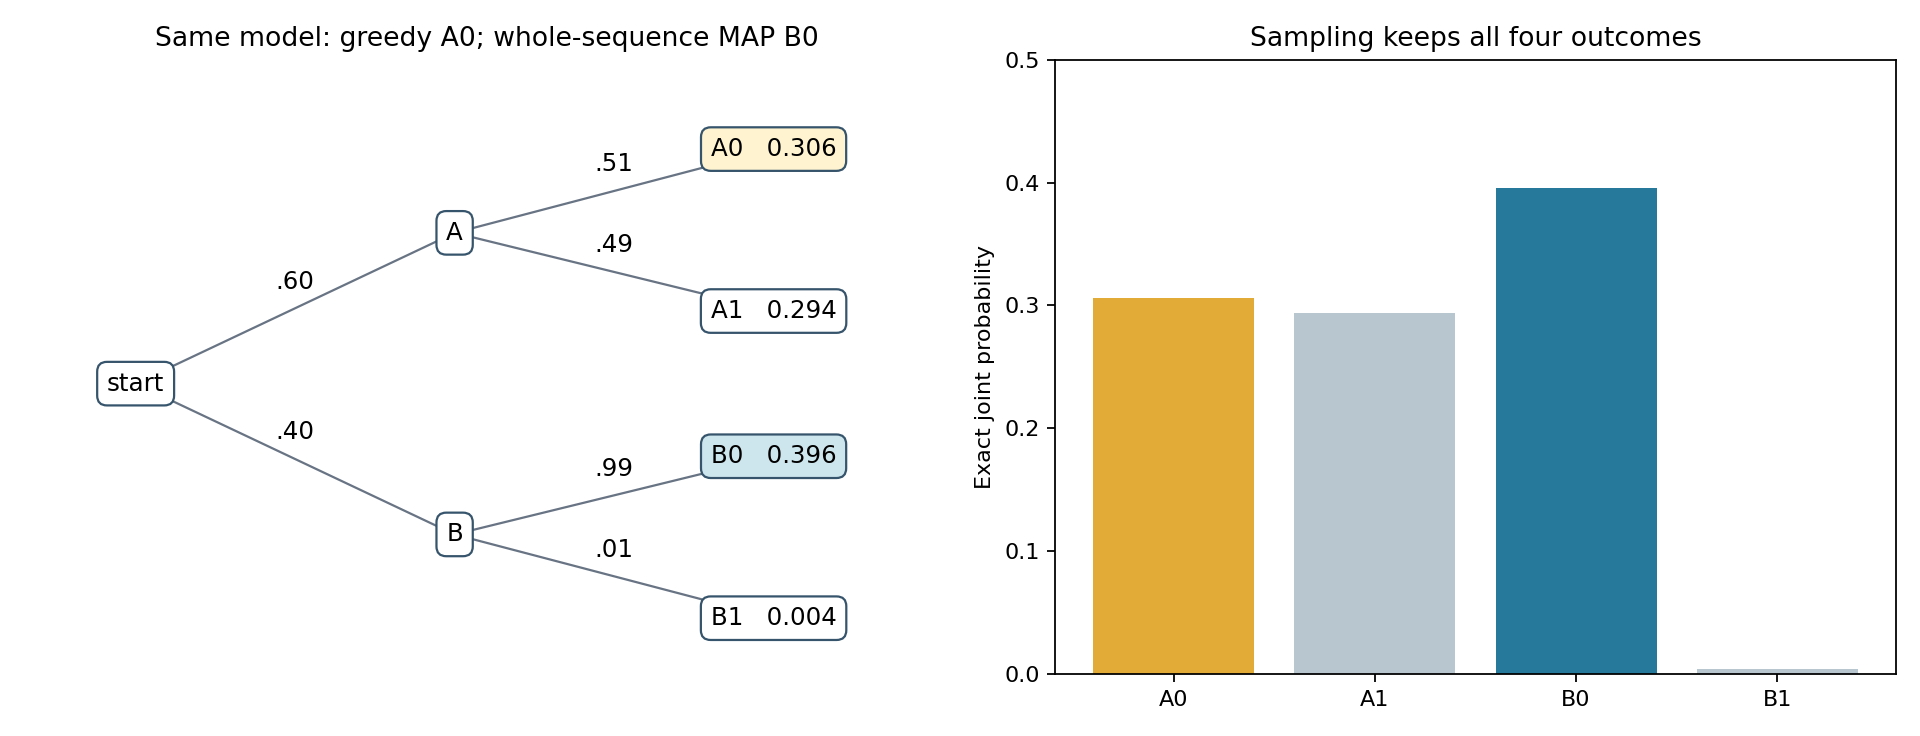
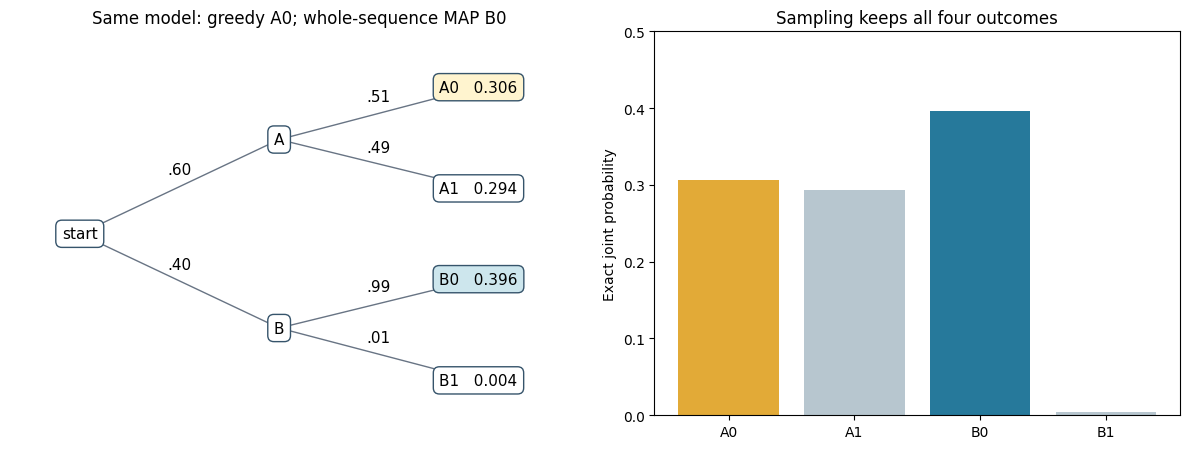
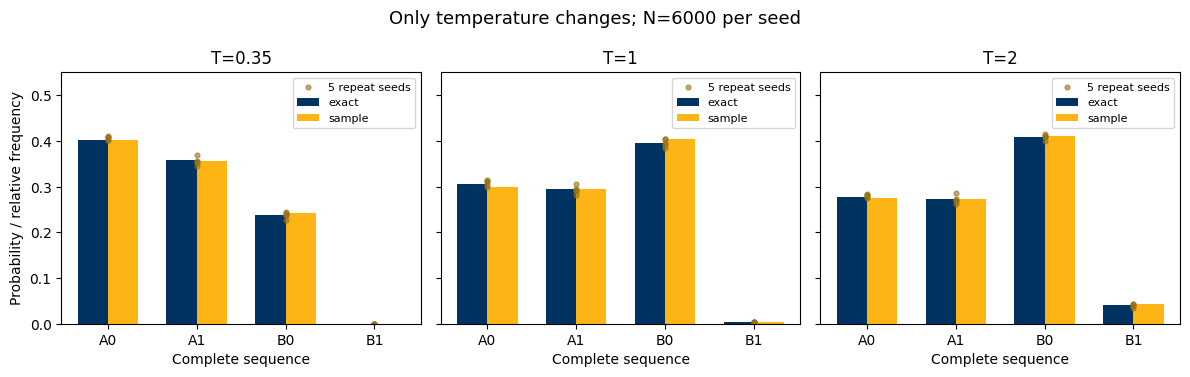
先沿树相乘:局部贪心走 A0(0.306),完整序列 MAP 是 B0(0.396)。采样保留四个结果,并不强制选 MAP。三温度图对每个温度重复5枚种子,点的波动与整组柱子的变化是不同现象。每个前缀各自归一化,因此逐 token 调温与整句概率调温通常不同。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-3f5f23b769b34b2db84a673efb6a82c0-005)
**结果身份:** 2026-09-28由下方同源Python代码在本地CPU实际生成并核对。手工指定两步概率模型,没有训练或调用语言模型。 图不是模型训练输出。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-3f5f23b769b34b2db84a673efb6a82c0-006)
[无需GPU的即时探索](https://codingai-lec04.pages.dev/course/experiments/lab01.html)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-3f5f23b769b34b2db84a673efb6a82c0-007)
保存数据、图片与代码随下载材料提供;静态图无需GPU。学生重算需要Python、NumPy、matplotlib,不发起网络请求、不打印密钥,只在当前目录写入本册输出文件夹。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-112c8a75b37e41b79c4ebe56d34bab0c-001)
## 只改一个变量:TRY_T
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-112c8a75b37e41b79c4ebe56d34bab0c-002)
把 TRY_T 从 1 改成 0.35 或 2。模型表、种子与每次6000个样本保持固定;精确概率与重复抽样同时变化。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-112c8a75b37e41b79c4ebe56d34bab0c-003)
在下面参数区改值后运行本格;重算图会显示在输出中,并保存在 `lab01-visual-output`。接着用图中的具体变化解释,不从一次样本判断整个分布。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-224f93b820ae476897d0ae7f68bfe5a3-001)
查看可执行代码
```
import math, json, time, platform
from pathlib import Path
import numpy as np
import matplotlib.pyplot as plt
# Change only this temperature, keeping the model table and sample count fixed.
TRY_T = 1.0
VISUAL_SEED = 20260928
VISUAL_N = 6000
OUT = Path('lab01-visual-output'); OUT.mkdir(exist_ok=True)
FIRST_VIS = np.array([.6,.4])
NEXT_VIS = np.array([[.51,.49],[.99,.01]])
SEQUENCES_VIS = ['A0','A1','B0','B1']
def vis_softmax_temperature(p, temperature):
assert temperature > 0
logp=np.log(p)/temperature; weights=np.exp(logp-logp.max())
return weights/weights.sum()
def vis_joint(temperature):
first=vis_softmax_temperature(FIRST_VIS,temperature)
second=np.stack([vis_softmax_temperature(row,temperature) for row in NEXT_VIS])
return (first[:,None]*second).flatten()
def vis_uniforms(seed,n):
# Portable 32-bit LCG; the browser uses exactly this stream, not a second dataset.
state=int(seed)&0xffffffff; values=[]
for _ in range(2*n):
state=(1664525*state+1013904223)&0xffffffff
values.append(state/4294967296)
return np.asarray(values).reshape(n,2)
def vis_counts(temperature,seed=VISUAL_SEED,n=VISUAL_N):
u=vis_uniforms(seed,n); first=vis_softmax_temperature(FIRST_VIS,temperature)
a=(u[:,0]>=first[0]).astype(int)
p0=np.array([vis_softmax_temperature(row,temperature)[0] for row in NEXT_VIS])
b=(u[:,1]>=p0[a]).astype(int)
return np.bincount(2*a+b,minlength=4)
fig,axes=plt.subplots(1,2,figsize=(12,4.6),gridspec_kw={'width_ratios':[1.1,1]})
ax=axes[0]; pos={'start':(0,.5),'A':(1,.77),'B':(1,.23),'A0':(2,.92),'A1':(2,.63),'B0':(2,.37),'B1':(2,.08)}
for a,b,label in [('start','A','.60'),('start','B','.40'),('A','A0','.51'),('A','A1','.49'),('B','B0','.99'),('B','B1','.01')]:
x,y=pos[a]; xx,yy=pos[b]; ax.annotate('',(xx,yy),(x,y),arrowprops={'arrowstyle':'->','color':'#687484'})
ax.text((x+xx)/2,(y+yy)/2+.035,label,ha='center',fontsize=11)
base=vis_joint(1)
for key,(x,y) in pos.items():
label=key if key not in SEQUENCES_VIS else f'{key} {base[SEQUENCES_VIS.index(key)]:.3f}'
ax.text(x,y,label,ha='center',va='center',bbox={'boxstyle':'round,pad=.4','fc':'#fff4cf' if key=='A0' else '#cde6ed' if key=='B0' else 'white','ec':'#36546b'},fontsize=11)
ax.set(xlim=(-.35,2.55),ylim=(-.02,1.08),title='Same model: greedy A0; whole-sequence MAP B0');ax.axis('off')
axes[1].bar(SEQUENCES_VIS,base,color=['#e2aa37','#b7c6cf','#26799b','#b7c6cf'])
axes[1].set(ylim=(0,.5),ylabel='Exact joint probability',title='Sampling keeps all four outcomes')
fig.tight_layout();fig.savefig(OUT/'lab01-tree.png',dpi=160);plt.show();plt.close(fig)
temperatures=[.35,1.,2.]
fig,axes=plt.subplots(1,3,figsize=(12,3.8),sharey=True); result=[]
for ax,T in zip(axes,temperatures):
exact=vis_joint(T); empirical=vis_counts(T)/VISUAL_N; reps=np.stack([vis_counts(T,VISUAL_SEED+i)/VISUAL_N for i in range(5)])
positions=np.arange(4)
ax.bar(positions-.17,exact,.34,label='exact',color='#003262');ax.bar(positions+.17,empirical,.34,label='sample',color='#fdb515')
ax.scatter(np.repeat(positions,5),reps.T.flatten(),s=12,c='#967318',alpha=.6,label='5 repeat seeds')
ax.set(xticks=positions,xticklabels=SEQUENCES_VIS,title=f'T={T:g}',ylim=(0,.55),xlabel='Complete sequence'); ax.legend(fontsize=8)
result.append({'T':T,'exact':exact.tolist(),'empirical':empirical.tolist(),'repeats':reps.tolist()})
axes[0].set_ylabel('Probability / relative frequency');fig.suptitle(f'Only temperature changes; N={VISUAL_N} per seed',fontsize=13)
fig.tight_layout();fig.savefig(OUT/'lab01-temperature.png',dpi=160);plt.show();plt.close(fig)
fig,ax=plt.subplots(figsize=(7,3.5)); exact=vis_joint(TRY_T); observed=vis_counts(TRY_T)/VISUAL_N
ax.bar(np.arange(4)-.17,exact,.34,label='exact',color='#003262');ax.bar(np.arange(4)+.17,observed,.34,label='sample',color='#fdb515')
ax.set(xticks=range(4),xticklabels=SEQUENCES_VIS,ylim=(0,1),ylabel='Probability',title=f'Your controlled change: T={TRY_T:g}');ax.legend();fig.tight_layout();fig.savefig(OUT/'lab01-your-temperature.png',dpi=160);plt.show();plt.close(fig)
payload={'kind':'finite constructed probability model; not an LLM','seed':VISUAL_SEED,'n':VISUAL_N,'table':{'first':FIRST_VIS.tolist(),'next':NEXT_VIS.tolist()},'comparisons':result,'changed':{'T':TRY_T,'exact':exact.tolist(),'observed':observed.tolist()},'python':platform.python_version(),'numpy':np.__version__}
(OUT/'lab01-results.json').write_text(json.dumps(payload,indent=2))
print(json.dumps(payload['changed'],indent=2))
assert abs(sum(base)-1)<1e-12 and SEQUENCES_VIS[int(base.argmax())]=='B0'
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-224f93b820ae476897d0ae7f68bfe5a3-output-0-001)
已保存输出;运行地点及条件见本册说明。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-224f93b820ae476897d0ae7f68bfe5a3-output-1-001)
已保存输出;运行地点及条件见本册说明。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-224f93b820ae476897d0ae7f68bfe5a3-output-2-001)
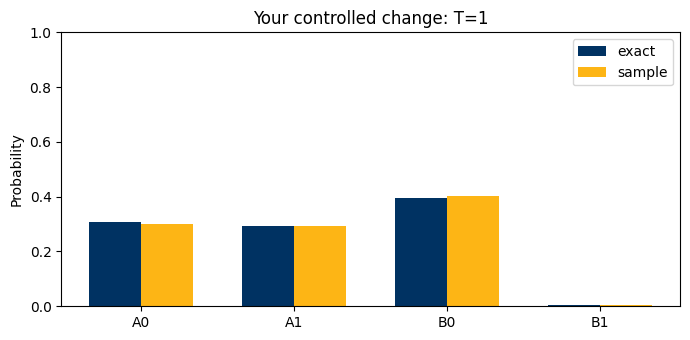已保存输出;运行地点及条件见本册说明。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-224f93b820ae476897d0ae7f68bfe5a3-output-3-001)
查看保存的计算输出
```
{
"T": 1.0,
"exact": [
0.306,
0.294,
0.396,
0.004
],
"observed": [
0.2995,
0.29383333333333334,
0.4035,
0.0031666666666666666
]
}
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-986a9e03ac034b77a81dd1eb2e0c8529-001)
## 本轮运行与后续阅读
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-986a9e03ac034b77a81dd1eb2e0c8529-002)
**本地执行与云端复核均已完成。** 2026-09-28,本册全部代码在本地CPU从空命名空间顺序执行;另通过Deepnote全本运行,状态为success,运行ID为 `584c0796-4d82-4548-aed1-ff4bea509572`,完成时间 2026-09-28T15:27:40.388Z(UTC)。运行快照检查到本册图形输出且无失败代码块。原模型逐步贪心A0、完整序列MAP B0;三温度精确概率和6000样本对照已输出。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-986a9e03ac034b77a81dd1eb2e0c8529-003)
云端运行使用Python 3.13数据科学环境。平台总用时包含启动、Notebook执行与输出保存,不作为算法速度基准;五本均为小规模CPU计算,不调用外部模型或付费API。上方静态图仍明确保留其本地生成来源,云端输出是另一次实际复核。学生修改参数后得到的是自己的新结果。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-986a9e03ac034b77a81dd1eb2e0c8529-004)
下面保留此前逐步计算与推导。历史本地数字保留原身份,可把图中一个关系追到对应公式。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-7653c5a67b224da4a432b6b9416e7edc-001)
## 固定对象:两个位置、四条序列
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-7653c5a67b224da4a432b6b9416e7edc-002)
所有序列都恰好长 2,没有 EOS、长度惩罚或词表截断。模型参数是下面手工指定的概率,不是训练出的语言模型。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-7653c5a67b224da4a432b6b9416e7edc-003)
链式法则给出 $p(x_1,x_2)=p(x_1)p(x_2\mid x_1)$。条件表的每一行都归一化,因此乘积也会成为一个归一化的联合分布。这里“第 2 步预测”可以使用第 1 个 token;若把两步都当作独立边际采样,就已经换了模型。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-e239e22a62db4243b1d50f5cbc5565f2-001)
查看可执行代码
```
import math
import random
from collections import Counter
FIRST = {"A": 0.6, "B": 0.4}
NEXT = {"A": {"0": 0.51, "1": 0.49},
"B": {"0": 0.99, "1": 0.01}}
def joint(first, nxt):
return {a + b: pa * pb
for a, pa in first.items()
for b, pb in nxt[a].items()}
BASE = joint(FIRST, NEXT)
first_choice = max(FIRST, key=FIRST.get)
greedy = first_choice + max(NEXT[first_choice], key=NEXT[first_choice].get)
map_sequence = max(BASE, key=BASE.get)
print("sequence | exact joint probability")
for seq, prob in BASE.items():
print(f"{seq:8s} | {prob:.6f}")
print("greedy =", greedy, "probability =", BASE[greedy])
print("global MAP =", map_sequence, "probability =", BASE[map_sequence])
assert abs(sum(BASE.values()) - 1) < 1e-12
assert greedy == "A0" and map_sequence == "B0"
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-e239e22a62db4243b1d50f5cbc5565f2-output-0-001)
查看保存的计算输出
```
sequence | exact joint probability
A0 | 0.306000
A1 | 0.294000
B0 | 0.396000
B1 | 0.004000
greedy = A0 probability = 0.306
global MAP = B0 probability = 0.396
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-033b4b5f8a1447bcb46124c202192b12-001)
### 历史本地保存输出(2026-09-26;本轮执行记录见开篇)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-033b4b5f8a1447bcb46124c202192b12-002)
```
sequence | exact joint probability
A0 | 0.306000
A1 | 0.294000
B0 | 0.396000
B1 | 0.004000
greedy = A0 probability = 0.306
global MAP = B0 probability = 0.396
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-033b4b5f8a1447bcb46124c202192b12-003)
## 解释一次失败,而不是给解码器排榜
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-033b4b5f8a1447bcb46124c202192b12-004)
贪心在第 1 步只比较 0.6 与 0.4,看不到分支后面概率怎样分散。`A` 分支把质量近乎对半分给两条路,`B` 分支几乎集中到 `B0`,于是完整序列的排序翻转。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-033b4b5f8a1447bcb46124c202192b12-005)
这个反例证明逐步局部最大不保证全局最大,并不证明真实语言任务应总取 MAP:最高概率句子与有用、正确、多样的回答也是不同目标。序列很长时,像本册一样穷举通常不可行。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-50d22d9f484044e49086020292284f47-001)
查看可执行代码
```
def temperature_distribution(distribution, temperature):
assert temperature > 0
# 对 log 概率缩放,减最大值避免数值溢出。
logits = {k: math.log(v) / temperature
for k, v in distribution.items()}
offset = max(logits.values())
weights = {k: math.exp(v - offset) for k, v in logits.items()}
total = sum(weights.values())
return {k: v / total for k, v in weights.items()}
def local_temperature(temperature):
first = temperature_distribution(FIRST, temperature)
nxt = {a: temperature_distribution(row, temperature)
for a, row in NEXT.items()}
return joint(first, nxt)
def entropy(distribution):
return -sum(p * math.log2(p) for p in distribution.values() if p)
def tv(p, q):
return 0.5 * sum(abs(p[k] - q[k]) for k in p)
print("T | local A0 A1 B0 B1 | H(bits) | local/global TV")
for temperature in (0.35, 1.0, 2.0):
local = local_temperature(temperature)
global_scaled = temperature_distribution(BASE, temperature)
numbers = " ".join(f"{local[k]:.4f}" for k in BASE)
print(f"{temperature:4.2f} | {numbers} | {entropy(local):.4f} | {tv(local, global_scaled):.6f}")
assert abs(sum(local.values()) - 1) < 1e-12
assert tv(local_temperature(1.0), BASE) < 1e-12
assert tv(local_temperature(0.35), temperature_distribution(BASE, 0.35)) > 0.05
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-50d22d9f484044e49086020292284f47-output-0-001)
查看保存的计算输出
```
T | local A0 A1 B0 B1 | H(bits) | local/global TV
0.35 | 0.4023 0.3588 0.2389 0.0000 | 1.5526 | 0.285792
1.00 | 0.3060 0.2940 0.3960 0.0040 | 1.6031 | 0.000000
2.00 | 0.2780 0.2725 0.4084 0.0410 | 1.7413 | 0.062151
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f9f05916ebf1430391c76b12bc81a2ec-001)
### 历史本地保存输出(2026-09-26;本轮执行记录见开篇)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f9f05916ebf1430391c76b12bc81a2ec-002)
```
T | local A0 A1 B0 B1 | H(bits) | local/global TV
0.35 | 0.4023 0.3588 0.2389 0.0000 | 1.5526 | 0.285792
1.00 | 0.3060 0.2940 0.3960 0.0040 | 1.6031 | 0.000000
2.00 | 0.2780 0.2725 0.4084 0.0410 | 1.7413 | 0.062151
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f9f05916ebf1430391c76b12bc81a2ec-003)
## 为什么整句温度与逐 token 温度不同?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f9f05916ebf1430391c76b12bc81a2ec-004)
局部温度在每个前缀下分别计算 $q_T(x_t\mid x_{
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f9f05916ebf1430391c76b12bc81a2ec-005)
`T=1` 恢复原分布;温度调整没有更新 FIRST 或 NEXT 的学习参数。表中熵描述本例完整序列的随机性,不是回答正确率。尤其不要把“每个给定前缀下的分布变平”直接推广为“任意自回归模型的完整序列熵必然单调增加”:温度也改变了访问不同前缀的频率。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-3634e300adf64553887866f99034beb6-001)
查看可执行代码
```
def draw(distribution, rng):
keys = list(distribution)
return rng.choices(keys, weights=[distribution[k] for k in keys], k=1)[0]
def sample_ar(temperature, rng):
a = draw(temperature_distribution(FIRST, temperature), rng)
b = draw(temperature_distribution(NEXT[a], temperature), rng)
return a + b
SEED, N, T = 20260926, 30000, 1.0
rng = random.Random(SEED)
observed = Counter(sample_ar(T, rng) for _ in range(N))
exact = local_temperature(T)
print(f"seed={SEED}, n={N}, T={T}")
print("sequence | expected | observed | absolute error")
for seq in BASE:
empirical = observed[seq] / N
print(f"{seq:8s} | {exact[seq]:.5f} | {empirical:.5f} | {abs(empirical-exact[seq]):.5f}")
max_error = max(abs(observed[s] / N - exact[s]) for s in BASE)
assert max_error < 0.015
print("sampling max absolute frequency error =", round(max_error, 6))
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-3634e300adf64553887866f99034beb6-output-0-001)
查看保存的计算输出
```
seed=20260926, n=30000, T=1.0
sequence | expected | observed | absolute error
A0 | 0.30600 | 0.30530 | 0.00070
A1 | 0.29400 | 0.29113 | 0.00287
B0 | 0.39600 | 0.39933 | 0.00333
B1 | 0.00400 | 0.00423 | 0.00023
sampling max absolute frequency error = 0.003333
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-e7faae84d81a43be920c073b25a380a2-001)
### 历史本地保存输出(2026-09-26;本轮执行记录见开篇)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-e7faae84d81a43be920c073b25a380a2-002)
```
seed=20260926, n=30000, T=1.0
sequence | expected | observed | absolute error
A0 | 0.30600 | 0.30530 | 0.00070
A1 | 0.29400 | 0.29113 | 0.00287
B0 | 0.39600 | 0.39933 | 0.00333
B1 | 0.00400 | 0.00423 | 0.00023
sampling max absolute frequency error = 0.003333
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-e7faae84d81a43be920c073b25a380a2-003)
## 只改一个条件:温度
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-e7faae84d81a43be920c073b25a380a2-004)
保持 FIRST、NEXT、样本量和种子固定,把下一格的 `TRY_T` 从 1 改为 0.35 或 2。先预测 `A0`、`B0` 和极少发生的 `B1` 哪一个增加,再看枚举与抽样。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-e7faae84d81a43be920c073b25a380a2-005)
先前一格展示的是采样频率是否符合指定分布;下一格的交叉熵则是另一个问题:如果未来数据仍由原始 BASE 产生,修改采样温度后的分布给这些数据多少概率?不能把这两个判断混为一谈。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-5b35ff2b202b4a8486609c4701f49724-001)
查看可执行代码
```
TRY_T = 2.0
changed = local_temperature(TRY_T)
rng_changed = random.Random(SEED)
changed_counts = Counter(sample_ar(TRY_T, rng_changed) for _ in range(N))
cross_entropy = -sum(BASE[s] * math.log2(changed[s]) for s in BASE)
forward_kl = sum(BASE[s] * math.log2(BASE[s] / changed[s]) for s in BASE)
print("changed temperature:", TRY_T)
for seq in BASE:
print(seq, "exact=", round(changed[seq], 5),
"observed=", round(changed_counts[seq] / N, 5))
print("H(BASE):", round(entropy(BASE), 6), "bits/sequence")
print("cross entropy H(BASE, changed):", round(cross_entropy, 6))
print("KL(BASE || changed):", round(forward_kl, 6))
assert abs(cross_entropy - entropy(BASE) - forward_kl) < 1e-12
assert forward_kl >= -1e-12
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-5b35ff2b202b4a8486609c4701f49724-output-0-001)
查看保存的计算输出
```
changed temperature: 2.0
A0 exact= 0.27801 observed= 0.2774
A1 exact= 0.2725 observed= 0.27057
B0 exact= 0.40844 observed= 0.4116
B1 exact= 0.04105 observed= 0.04043
H(BASE): 1.603095 bits/sequence
cross entropy H(BASE, changed): 1.646546
KL(BASE || changed): 0.043451
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-5c3ea6dd5c61409ca2af211e3f3dccfd-001)
### 历史本地保存输出(2026-09-26;本轮执行记录见开篇)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-5c3ea6dd5c61409ca2af211e3f3dccfd-002)
```
changed temperature: 2.0
A0 exact= 0.27801 observed= 0.2774
A1 exact= 0.2725 observed= 0.27057
B0 exact= 0.40844 observed= 0.4116
B1 exact= 0.04105 observed= 0.04043
H(BASE): 1.603095 bits/sequence
cross entropy H(BASE, changed): 1.646546
KL(BASE || changed): 0.043451
```
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-5c3ea6dd5c61409ca2af211e3f3dccfd-003)
## 带着数据回答
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-5c3ea6dd5c61409ca2af211e3f3dccfd-004)
- 用四个联合概率说明,为什么 `A0` 是逐步贪心答案,`B0` 才是 MAP?
- 选择一行 `T != 1`,解释局部温度与整体温度的 TV 为什么非零。
- 分别报告 `B1` 的概率、完整序列熵和相对 BASE 的交叉熵。哪些指标增加了?这能说明语义质量吗?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-5c3ea6dd5c61409ca2af211e3f3dccfd-005)
可请 AI 用你实际运行的四行表解释;先让它核对模型表没有随温度一起变化,再讨论观察。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-aeb2d98ce9af46f98e833751c44b8667-001)
## 本册证据的边界
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-aeb2d98ce9af46f98e833751c44b8667-002)
这是手工概率模型的精确枚举与伪随机抽样,没有数据训练、神经网络、长上下文或语义评价。本地保存输出来自执行这些代码;Deepnote 是否重跑应以平台运行记录为准。抽样误差会随样本量变化,精确概率不受种子影响。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-aeb2d98ce9af46f98e833751c44b8667-003)
链式法则与信息量的背景可读 [Deep Learning:Probability and Information Theory](https://www.deeplearningbook.org/contents/prob.html)。本册反例和数值为教学构造,不是该书报告的实验结果。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-7aecc644adaf455e9a833597754725b3-001)
## 接回主讲
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-7aecc644adaf455e9a833597754725b3-002)
回到“把联合概率拆成下一步”“训练与生成的前缀不同”“温度改变采样分布”三处。下一步若研究真实语言模型,应固定模型、提示、长度和解码配置,再分别评价质量与多样性;本册不替这些实验预判结果。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-e0777fc492b248218984af651b4c15d6-001)
## 从课堂展开:推导、反例与变量实验
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-e0777fc492b248218984af651b4c15d6-002)
先完成上面的有限例子,再按自己尚未弄清的问题选择推导。已有代码只覆盖本册明确列出的计算;后面的研究练习是可继续提出的实验,不是已经运行的结果。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-e0777fc492b248218984af651b4c15d6-003)
- [从当前课堂回到这套概率表](https://deepnote.com/project/6f83a923-d155-47be-be58-680db701ff7f/notebook/39071d41f84d4621ad69c6140a6dccc9?utm_source=openai&utm_medium=mcp&utm_campaign=openaimcp&utm_content=39071d41f84d4621ad69c6140a6dccc9&utm_term=get_notebook#f8bca478ae9148978d09113d71f6ee06)
- [输入和标签为什么错开一个位置](https://deepnote.com/project/6f83a923-d155-47be-be58-680db701ff7f/notebook/39071d41f84d4621ad69c6140a6dccc9?utm_source=openai&utm_medium=mcp&utm_campaign=openaimcp&utm_content=39071d41f84d4621ad69c6140a6dccc9&utm_term=get_notebook#4a770ec239d14b6a9691935d71b7766a)
- [真实前缀与自身前缀,为何可能带来不同表现](https://deepnote.com/project/6f83a923-d155-47be-be58-680db701ff7f/notebook/39071d41f84d4621ad69c6140a6dccc9?utm_source=openai&utm_medium=mcp&utm_campaign=openaimcp&utm_content=39071d41f84d4621ad69c6140a6dccc9&utm_term=get_notebook#a411c825c6514134bb2bccbb2263250e)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-e0777fc492b248218984af651b4c15d6-004)
原有解释按连续主题拆到下方;本入口继续保留。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-001)
### 从当前课堂回到这套概率表
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-002)
N09 的依赖关系在此变为四个可枚举结果;N11 的训练/生成差别是前缀来源。对真实序列 A0,训练第二项读取 A 并给真实 0 评分;自由生成若先抽到 B,下一项必须用 NEXT[B],不能继续查 A 行。teacher forcing 允许真实过去,不允许当前目标提前进入输入。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-003)
N10 的木球问题可做纯手算状态表:起点3颗,取出1颗后2颗,再放入2颗后4颗。把最后事件从放入2颗改成取出2颗,答案应为0颗。这与 N56 回访的是同一事件序列。该对照检验目标需要哪些信息,不是本册四格代码已经测得语言模型状态能力。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-004)
外部条件 c 与生成前缀来自不同位置。固定前缀“桌上有一只”,分别给猫照片和狗照片,正确的条件分布应响应输入对象。可用两份手写条件表验证 p(x|c)=∏p(x_i|x_
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-005)
下列进一步阅读分成“联合关系与上下文”“似然与信息边界”“解码与采样检查”三组,数值实验继续使用 A0、A1、B0、B1 四种序列。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-006)
### 两个各自正确的边缘分布,仍能拼出错误世界
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-007)
分别学会每个变量,为什么还不够?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-008)
考虑本课程的两盏灯算例:真实数据只有同时关闭和同时打开,各占一半。单看第一盏或第二盏,亮灯概率都是二分之一。如果独立地从两个边缘分布采样,四种组合会各占四分之一,于是得到真实数据从未出现的一亮一灭。两个边缘分布都被精确拟合,联合分布却错了。这不是网络规模不足造成的,而是独立生成时丢掉了变量关系。自回归通过条件分布保留这种依赖,也说明“每个局部看起来合理”不足以保证整体合理。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-009)
**追问:**两个单灯预测都百分之百符合统计,为什么整幅图仍然错?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-010)
因为每个变量的边缘概率没有记录它与另一个变量一起出现的方式。原数据要求两盏灯一致,独立采样没有执行这个限制。联合概率可以有相同的行和列总和,却在四个格子里分配不同质量。你需要检查成对事件的频率,或者显式学习给定第一盏灯以后第二盏灯的条件概率。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-011)
[返回当前页说明](https://codingai-lec04.pages.dev/classroom/N09.html?view=notes)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-012)
相关阅读:[Autoregressive Models](https://mit-6s978.github.io/assets/pdfs/lec3_ar.pdf)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-013)
### 条件概率是在一条已知分支上重新归一化
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-014)
知道第一盏灯亮了,第二盏灯的分布怎样改变?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-015)
延续两灯例子,当第一盏灯亮时,第二盏灯亮的条件概率为一;第一盏灯灭时,第二盏灯亮的条件概率为零。计算条件概率时,先只保留与已知条件相容的联合事件,再除以该条件事件的总概率。边缘概率二分之一与条件概率零或一并不矛盾,因为它们回答不同问题。概率树中每个节点的出边应加和为一,但整条路径的概率需要相乘。条件事件概率为零时,不能直接用通常的比值定义该条件分布。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-016)
**追问:**条件概率变成一,是不是模型突然对整个世界都没有不确定性了?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-017)
它只是在这个精确算例、这个给定条件下对第二盏灯没有不确定性。第一盏灯本身仍然随机,因此整个二变量样本仍有两种可能。不要把一个条件节点的确定性扩展为整个联合分布的确定性。实际任务还要检查条件是否可靠、是否见过,以及数据关系是否真的像本例这样完全一致。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-018)
[返回当前页说明](https://codingai-lec04.pages.dev/classroom/N09.html?view=notes)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-019)
相关阅读:[Autoregressive Models](https://mit-6s978.github.io/assets/pdfs/lec3_ar.pdf)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-020)
### 只看最近一个 token,是新的模型假设
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-021)
p(xᵢ|x<ᵢ) 什么时候能简化为 p(xᵢ|xᵢ₋₁)?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-022)
完整链式分解允许当前位置依赖全部前缀。若把条件只保留为最近一个变量,就变成一阶 Markov 假设;在某些过程上合理,在另一些过程上会丢失长期信息。构造序列:第一个符号决定最后一个符号,中间全是相同占位符。只看最后一个占位符无法知道首符号,而完整前缀可以。这个例子为课程补充,用来定位上下文截断的代价。实际语言模型的有限窗口也是一种可用信息边界,不能与无条件独立或完整历史建模混称。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-023)
**追问:**名字叫自回归,是不是天然只使用上一步输出?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-024)
不是。“把已有输出作为条件”没有限定只能保留一个输出。完整自回归因子可以使用整个前缀,也可以通过隐藏状态压缩过去。只看一个位置是另外施加的假设。评估模型时需要问清上下文窗口和状态表示,不能仅从“自回归”这个名称推断它能记住多少历史。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-025)
[返回当前页说明](https://codingai-lec04.pages.dev/classroom/N09.html?view=notes)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-026)
相关阅读:[Autoregressive Models](https://mit-6s978.github.io/assets/pdfs/lec3_ar.pdf)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-027)
### 乘积变求和:负对数似然落到每个位置
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-028)
为什么训练代码经常只有一个交叉熵?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-029)
对数把序列概率的乘积变成条件对数概率之和,所以负对数似然是每个真实下一 token 的负对数概率相加。离散输出配合 one-hot 标签时,这就是常用交叉熵。若两个位置分别给真实 token 概率0.8和0.5,整段概率为0.4,总负对数似然为−log0.8−log0.5。该数值例为课程补充。按 token 求平均与按序列求平均会改变不同长度样本的权重;需要在实现和报告中明确归一化方式。条件概率过低的那个位置会贡献较大损失,可据此定位具体预测问题。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-030)
**追问:**每个 token 都做分类,为什么整件事还能叫生成模型?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-031)
局部分类器预测的是给定前缀时下一变量的分布。将这些条件分布按链式法则组合,就定义了整个序列的联合分布;再逐步从中采样,就得到完整序列。局部计算形式像分类,不妨碍整体用于生成。关键是条件如何变化、各局部分布怎样组合,以及生成时怎样接回前一步结果。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-032)
[返回当前页说明](https://codingai-lec04.pages.dev/classroom/N10.html?view=notes)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-f8bca478ae9148978d09113d71f6ee06-033)
相关阅读:[Autoregressive Models](https://mit-6s978.github.io/assets/pdfs/lec3_ar.pdf) · [Generative Models (part 1)](https://cs231n.stanford.edu/slides/2026/lecture_13.pdf)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-001)
### 输入和标签为什么错开一个位置
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-002)
模型正在预测输入位置,还是下一个位置?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-003)
对序列“红、杯、结束”,可用“开始、红、杯”作为输入,对应标签是“红、杯、结束”。每个位置的表示据此预测下一个符号。开始和结束标记是常见实现约定;具体分词器可有不同处理,但输入目标错位必须一致。若把输入与标签原样对齐,再允许当前位置读取自身,就可能训练成复制器。这个短序列为课程构造,服务于原课的目标右移一格图。检查损失时还应排除填充位置,避免模型从大量无意义标签获得看似很好的平均分数。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-004)
**追问:**我把完整句子输入网络,再让它输出同一句子,损失也下降了,哪里错?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-005)
这可能是在做重构或复制,而不是下一步预测。若当前位置能够直接读取真实目标,它不必利用前缀建立预测能力。需要检查输入标签是否错开、因果遮罩定义与损失位置是否一致。训练损失下降只能说明当前代码中的目标变容易了,不能证明实现了想要的自回归概率分解。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-006)
[返回当前页说明](https://codingai-lec04.pages.dev/classroom/N11.html?view=notes)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-007)
相关阅读:[Autoregressive Models](https://mit-6s978.github.io/assets/pdfs/lec3_ar.pdf)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-008)
### 一条路径的概率,与一个节点的概率
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-009)
选到“新深色轿车”究竟有多大概率?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-010)
使用原课车辆树结构,另设本课程数值:轿车概率0.6,给定轿车时深色概率0.25,给定深色轿车时新车概率0.8。那么抽到新深色轿车的联合概率为0.12,而不是0.8。后一个数只在已经走到深色轿车节点后成立。若问所有新车的概率,则要把不同车型、颜色路径中属于新车的概率加起来。这个算例让采样轨迹和概率运算一一对应,也可以用于验证自编采样器的长期频率。把所有叶节点概率相加,还应重新得到总概率一。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-011)
**追问:**最后一步模型很有把握,为什么完整结果还是很罕见?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-012)
因为走到这个条件可能本来就很罕见。条件概率评价已知前提下的相对可能性,联合概率还需要把前提发生的概率算进去。一个完整长序列的概率常常很小,并不必然意味着每个局部预测都很差。比较时应说明长度和归一化方式,避免把低联合概率直接解释成低质量。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-013)
[返回当前页说明](https://codingai-lec04.pages.dev/classroom/N12.html?view=notes)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-014)
相关阅读:[Autoregressive Models](https://mit-6s978.github.io/assets/pdfs/lec3_ar.pdf)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-015)
### 温度改变输出分布,不改变已训练权重
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-016)
降低温度以后,模型真的学到了更多吗?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-017)
本页为课程补充算例,原课页码只提供条件分布背景。给定logits [0,1,2],温度T通过softmax(z/T)改变归一化概率。T降低时最大项更集中,T增大时更平缓;只有T为正才使用这个公式。参数θ并未改变,改变的是从模型分数到抽样概率的映射。更平缓可能带来更多变化,也可能增加错误;更集中可能提高某些一致性却降低覆盖。词表有并列最大值时,零温极限仍需说明如何处理并列。比较时同时记录概率表与实际抽样结果,避免用几次偶然输出判断趋势。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-018)
**追问:**温度高生成得更奇怪,是不是等于模型更有创造力?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-019)
这里只能证明概率变平、较低分候选更可能出现,不能单凭奇怪程度定义创造力。是否有价值、是否满足条件、是否保持事实与结构,都需要任务标准。你应在相同模型、提示和样本预算下比较,并同时记录成功与失败。采样分布更宽是机制事实,创造力更好是另一个尚需证据的评价。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-020)
[返回当前页说明](https://codingai-lec04.pages.dev/classroom/N12.html?view=notes)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-021)
相关阅读:[Autoregressive Models](https://mit-6s978.github.io/assets/pdfs/lec3_ar.pdf)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-022)
### 每一步选最大,并不保证整条序列最大
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-023)
局部最优为什么可能拼不出全局最优?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-024)
课程自编两步树:第一步P(A)=0.6、P(B)=0.4;A后P(0)=0.51,B后P(0)=0.99,其余概率由补数给出。贪心先选A再选0,得到A0,路径概率0.306;但B0概率0.396更大。两步局部选择无法预先比较全部后续分支,因此贪心结果未必是联合概率最大者。这个反例也不说明最高概率句子必然最符合人的任务要求;搜索目标、采样目标和语义质量仍要分别定义。原课提供链式结构,数值与反例由课程补充。即使穷举这个小树没有困难,长序列的分支数量仍会随长度迅速增加。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-025)
**追问:**既然最高概率完整序列更好,我们是否应该永远搜索它?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-026)
最高联合概率只是一个明确定义的优化目标,不自动等于对用户最有用或最多样的输出。搜索还有计算成本与长度偏置等问题。若任务要求从模型分布抽样,永远返回同一最高概率序列反而改变了目标。先确认要的是随机样本、最可能路径还是满足外部约束的结果,再选择解码规则。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-027)
[返回当前页说明](https://codingai-lec04.pages.dev/classroom/N12.html?view=notes)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-028)
相关阅读:[Autoregressive Models](https://mit-6s978.github.io/assets/pdfs/lec3_ar.pdf)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-029)
### 检验采样器,不能只看一条顺眼的序列
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-030)
概率实现正确,怎样留下可检查的证据?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-031)
课程实验可先使用完整已知的小联合表,通过条件树生成大量样本,再比较每条路径的理论概率与经验频率。实验中固定概率表、随机数算法和样本预算,并保留种子,便于定位实现错误。有限样本与理论概率不必完全一致,因此应观察不同样本量下偏差的变化,而不是要求每一批都精确命中比例。随后故意让采样器忽略条件,检查它何时仍能匹配部分边缘统计。这个对照能揭示只看边缘或精选样本的盲点。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-032)
**追问:**固定种子每次都得到一样结果,能否证明代码正确?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-033)
只能证明在当前环境和设置下执行可复现。一个错误的条件索引也可以非常稳定地复现。正确性需要把输出与目标分布的可计算统计比较,并进行能区分正确与错误实现的对照。种子、统计检验和代码检查分别解决不同问题;三者都重要,但不能互相替代。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-034)
[返回当前页说明](https://codingai-lec04.pages.dev/classroom/N12.html?view=notes)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-4a770ec239d14b6a9691935d71b7766a-035)
相关阅读:[Autoregressive Models](https://mit-6s978.github.io/assets/pdfs/lec3_ar.pdf)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-a411c825c6514134bb2bccbb2263250e-001)
### 真实前缀与自身前缀,为何可能带来不同表现
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-a411c825c6514134bb2bccbb2263250e-002)
一个早期选择会怎样改变后面的任务?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-a411c825c6514134bb2bccbb2263250e-003)
训练常在真实数据前缀上评价下一步概率;自由生成时前缀由模型先前的选择构成。某些罕见或错误选择可能把后续计算带到训练较少覆盖的条件区域,进而出现连锁变化。这个现象不等于每次偏离参考文本都是错误,因为多解任务本来允许其他合理续写。需要区分不一样、违反条件和结构失效,再设计对照。可以固定模型与后续随机数,在某个位置替换一个token,观察后面哪些变化来自前缀而非重新训练。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-a411c825c6514134bb2bccbb2263250e-004)
**追问:**只要输出与参考答案不一样,就说明出现了 exposure bias 吗?
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-a411c825c6514134bb2bccbb2263250e-005)
不能。参考可能只是条件分布中的一个样本,另一个续写也可能合理。要先定义失败标准,再检查失败是否与自身前缀引起的分布变化相关。即便观察到相关,也需要排除目标不匹配、模型能力不足等解释。不要用一个术语把所有生成差异打包,否则既无法验证,也难以改进。
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-a411c825c6514134bb2bccbb2263250e-006)
[返回当前页说明](https://codingai-lec04.pages.dev/classroom/N14.html?view=notes)
[区块原文](https://codingai-lec04.pages.dev/course/notebooks/39071d41f84d4621ad69c6140a6dccc9.html#block-a411c825c6514134bb2bccbb2263250e-007)
相关阅读:[Autoregressive Models](https://mit-6s978.github.io/assets/pdfs/lec3_ar.pdf)